
現実の走行環境に対応できる、信頼性の高い自動運転システムをつくるには、多様な交通シナリオのデータが欠かせません。しかし、ペタバイトオーダーの走行データから特定のシナリオを探し出す作業は、開発における大きなボトルネックになり得ます。ティアフォーでは、内製基盤 Mobility Observer(MOB)で走行データを収集・蓄積し、検索や可視化を通じて自動運転システムの状態を把握できるようにしています。今回、このMOBの走行データ検索機能に、NVIDIA Cosmos Embed1を用いた自然言語によるシーン検索機能を追加しました。本記事では、この機能が必要になった背景を整理したうえで、検索アプローチの選定、既存の検索基盤への統合、Graphics Processing Unit(GPU)推論のコスト最適化といった設計判断と実装の詳細を紹介します。
走行データ検索の課題
自動運転車両の開発と走行にともない、走行データは日々蓄積されていきます。MOBに蓄積された走行データの総量は、ペタバイトオーダーにのぼります。これらのデータは、記録したままの形(生のrosbagファイル)では扱いにくいため、用途に応じた前処理のパイプラインを通します。映像フレームを画像として抽出したり、後述するシーンタグを付与したりといった処理です。こうしてティアフォーの走行データから抽出されたカメラ動画だけでも、9,000時間を超えます。
走行データの難しさは、量の多さだけではありません。同じ市街地を走ったログでも、天候や時間帯、交通量、周囲の車両や歩行者の振る舞いはさまざまです。自動運転の開発では、この多様なデータの中から特定の状況を狙って取り出す作業が、繰り返し発生します。この作業は、認識モデルに限らず経路計画やEnd-to-Endといった、多様な走行シーンに対応したモデルを開発するには欠かせません。こうしたモデル開発の一例として、カメラのみ・高精度地図なしで動作するEnd-to-Endモデルをオープンソースソフトウェアとして公開した取り組みを、別の記事で紹介しています。
特定のシーンを取り出す作業のなかで、とりわけ重要なのが出現頻度の低いLong Tailのシーンです。たとえば、工事による車線規制や道路上の落下物といった状況がこれにあたります。ありふれたシーンをいくら集めても、こうした状況を扱えるモデルにはなりにくく、学習用にも評価用にも意図して集める必要があります。そのため、目的のシーンを効率よく取り出せるかどうかが、開発効率を大きく左右します。
自然言語によるシーン検索機能
MOBには、もともとメタデータやシーンタグによる走行データの検索機能がありました。メタデータでは、日時、車両、位置情報、配信されたファームウェアのバージョンなどを指定できます。シーンタグは、走行データの登録時にカメラ映像を入力できるマルチモーダルLarge Language Model(LLM)が付与するもので、天候や道路形状といった属性で絞り込めます。このシーンタグによる検索を含め、走行データの収集から学習データセットの作成までのパイプラインは、AWS Summit Japan 2026の講演資料で紹介しています。
今回、これらの検索機能に新たに加わる形で、自然言語によるシーン検索機能を設計し実装しました。この機能は、入力した文章をそのままベクトルに変換し、映像のベクトルと照らし合わせて近いシーンを探す仕組みです。そのため、複数の要素が絡んだ文脈も、厳密にクエリ条件を組み立てずに指定できます。この曖昧さを許容できる点が、Long Tailのシーンを抽出するうえでの利点になります。
実際の検索では、検索ボックスに探したいシーンを英文で記述すると、その内容に合致する走行シーンが返ってきます。キーワードの一致ではなく、映像の意味的な内容に基づくマッチングです。たとえば、次のようなシーンを探せます。
-
交通参加者との関係:「a pedestrian crossing the road in front of the car」(自車前方を横断する歩行者)、「waiting behind a bus at a bus stop」(バス停でバスの後ろに停車)、「driving behind a truck at night」(夜間にトラックの後ろを走行)
-
道路上のイベント:「workers and traffic cones blocking the lane」(作業員とコーンによる車線規制)、「passing a construction site」(工事現場の脇を通過)
-
環境条件:「intersection on a rainy day」(雨の日の交差点)、「driving on a wet road in the rain」(雨天の濡れた路面)
いずれも、探したい状況をそのまま英文で書くだけで検索できます。
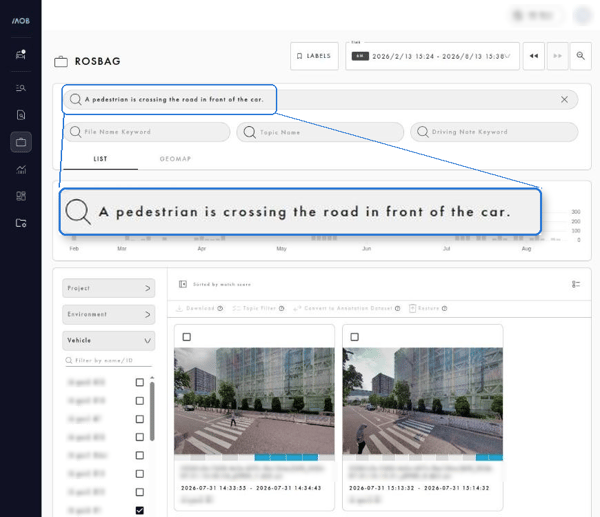
図1:検索UIのスクリーンショット(自然言語クエリと検索結果)
検索体験としてのポイントは2つあります。
1つ目は、既存の検索条件と組み合わせられることです。MOBの走行データ検索には、前述のメタデータによるファセット検索が備わっており、自然言語検索はこれと同時に指定できます。つまり、走行期間や車両、走行エリアといった条件で対象を絞り込みつつ、その中から工事現場の脇を通過するシーンを探す、といった使い方ができます。
2つ目は、検索結果がセグメント単位であることです。本機能では、走行データを5秒ごとに区切った区間を「セグメント」と呼び、この単位で検索を行います。走行データファイル単位ではなく、「どのデータのどの時間帯か」まで特定して結果が返ります。ヒットしたシーンはその場で再生できるため、長時間のデータを先頭から確認する必要はありません。
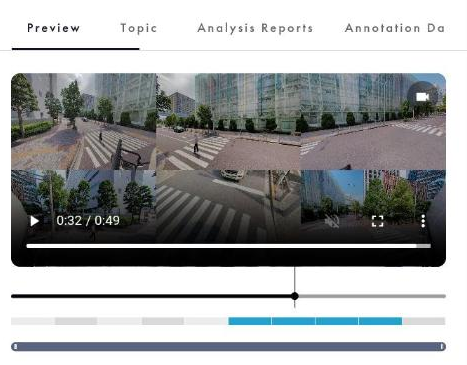
図2:検索結果からシーン再生への遷移
これにより、機械学習のアノテーション対象データの収集、不具合解析での状況特定、テストシナリオの素材探しなど、走行データを扱う多くの場面で、目的のシーンを素早く探せるようになりました。
設計方針 — キャプションを介さないembedding直接検索
ここからは、今回開発した検索機能の設計を紹介します。最初に決めたのは、映像を自然言語で検索するための大きな方向性です。代表的なアプローチは2つあります。
1つは、Vision-Language Model(VLM)で映像からキャプションやタグをあらかじめ生成しておき、それをテキストとして検索する方法です。構造化されたタグによる厳密なフィルタリングに強く、生成したキャプション自体をアノテーションなど別の用途にも使えます。もう1つは、video embeddingモデルで映像を直接ベクトル化し、クエリテキストと同じベクトル空間で近傍検索する方法です。テキストという中間表現を介さないため、取り込み時の推論が軽く、検索条件の型をあらかじめ決めておく必要もありません。
MOBの要件は2つありました。1つ目は、登録されるすべての走行データを最小の追加コストで登録直後から検索可能にすることです。2つ目は、あらかじめ検索条件の型を決めておかなくても、複数の要素を組み合わせた文脈をそのまま書けることです。つまり、先に挙げたような英文を、そのまま検索条件にできるということです。この要件から、本機能では後者のembeddingによる直接検索を採用しました。
構造化されたタグによる厳密な絞り込みは、前述のメタデータとシーンタグが引き続き担います。自然言語検索はこれらを置き換えるものではなく、3つ目の軸として併存させる設計にしました。この住み分けがあるため、embedding直接検索の利点をそのまま引き出すことができます。
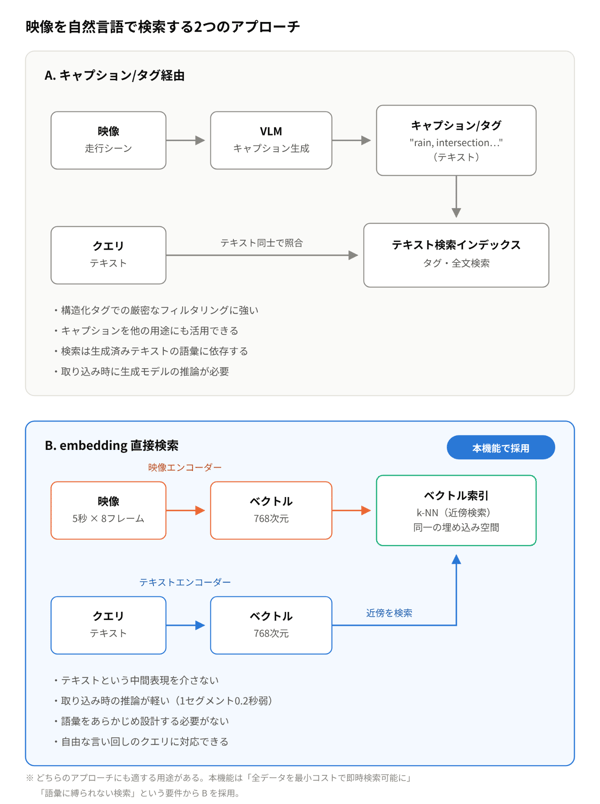
図3:2つのアプローチ — キャプション/タグ経由の検索と embedding直接検索
採用したモデルは、NVIDIAのフィジカルAI向けモデル郡Cosmosに含まれるCosmos Embed1です。本モデルは、映像用とテキスト用の2つのエンコーダーを持つdual-encoder構成をとっており、ロボティクスや自動運転を含む約800万本の映像・キャプションペアで学習されています。対照学習(contrastive learning)により、両エンコーダーの出力は同一の768次元空間に揃えられています。そのため「テキストで映像を探す」というクロスモーダル検索は、ベクトルのk近傍探索(k-NN)に帰着します。出力ベクトルは正規化されており、近さがそのまま意味的な類似度に対応します。
Cosmos Embed1の映像エンコーダーは、1クリップあたり8フレームの入力を前提に設計されています。走行映像というドメインへの適性と、後述するとおり1セグメント0.2秒弱まで詰められる推論の軽さが、採用の決め手になりました。
全体アーキテクチャ
本機能は、検索時の「クエリ側」と、走行データ取り込み時の「インデックス側」という2つのデータフローで構成されています。
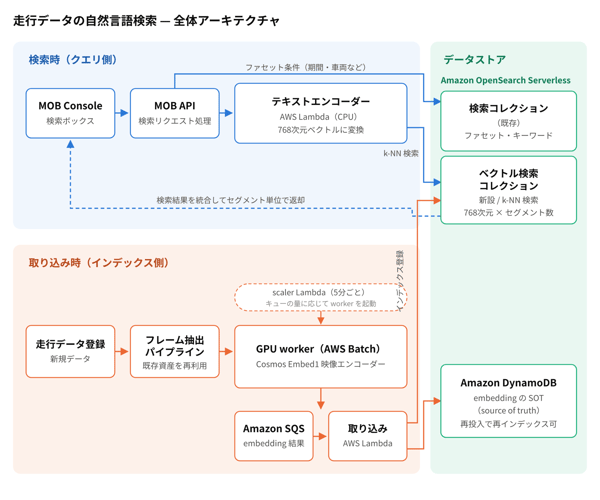
図4:全体アーキテクチャ図
検索時の流れ(クエリ側)
入力された検索テキストは、AWS Lambda上で動作するCosmos Embed1のテキストエンコーダーによって768次元のベクトルに変換されます。テキストのエンコードは軽量なため、GPUを使わずCPUのLambdaで実行してもウォームスタートで約100msで完了します。Provisioned Concurrencyを設定し、コールドスタートが検索の応答時間に影響しないようにしています。
このベクトルを使って、Amazon OpenSearch Serverlessのベクトル検索コレクションに対してk-NN検索を実行します。このとき、期間や車両といったファセット条件はベクトル検索側のフィルタとしても適用され、絞り込まれた母集合の中から近傍を探します。得られたセグメント群を走行データ単位に集約し、既存のファセット検索の結果と突き合わせて、最終的な検索結果を組み立てます。
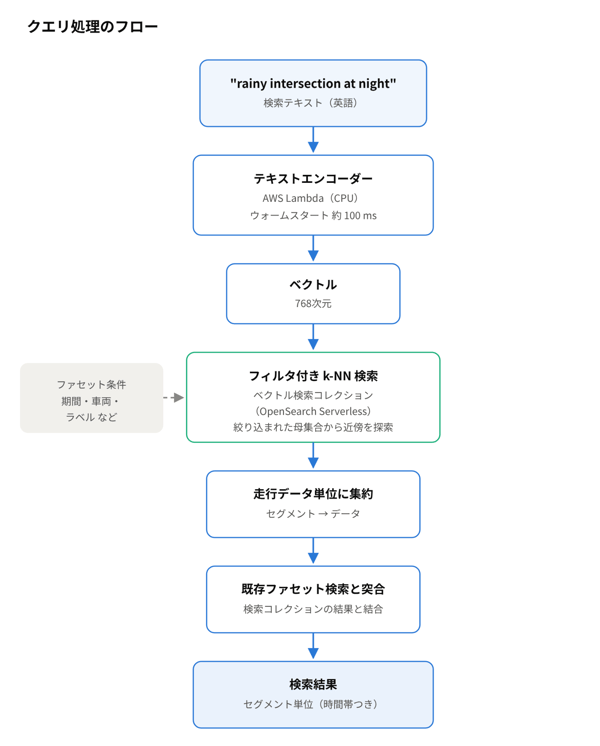
図5:クエリ処理のフロー(テキスト→ベクトル→フィルタ付き k-NN→集約)
なお、従来の検索機能の安定性を損なわないよう、既存の検索用コレクションには手を入れず、ベクトル検索専用のコレクションを新設する構成にしました。
取り込み時の流れ(インデックス側)
MOBには、走行データの登録時に映像フレームを画像として抽出する既存のパイプラインがあります。自然言語検索のためのインデックスパイプラインでは、この資産を再利用しており、embeddingの生成のために動画をあらためてデコードすることはありません。抽出済みのフレームを5秒ごとのセグメントに区切り、GPU workerが各セグメント8フレームの入力からvideo embeddingを生成します。
生成されたembeddingはAmazon SQSを経由して取り込まれます。ここでは「重複を厳密に防ぐ」のではなく、「重複しても壊れない」設計を選びました。メッセージ配信はat-least-onceを前提に、走行データとセグメント番号の組をキーとする冪等(べきとう)なupsertで重複を吸収します。検索インデックス側に紛れ込んだ重複ドキュメントは、周期的なクリーンアップで除去します。取り込みパスから事前の存在チェックをなくすことで、実装を単純に、スループットを高く保てます。
Source of Truth(SOT)はAmazon DynamoDBに置いています。768次元のfloat32ベクトルをバイナリにパックし、1項目3,072バイトで格納する方式です。数値のリスト型で保存する場合と比べて、読み取りコストを約3割、読み取りレイテンシを約9割削減できました。検索インデックスは、このDynamoDBからいつでも再構築できる「派生データ」という位置づけです。インデックスを作り直すときも障害からの復旧でも、GPUによる再推論は必要ありません。
セグメント単位でembeddingを持つ設計にしたのは、検索の答えを「どのデータか」ではなく「データの中のどこか」にしたかったからです。1つの走行データの中には、直線道路のシーンと交差点のシーン、歩行者が横断しているシーンとしていないシーンが混在し得ます。5秒という粒度は、こうしたシーンの切り替わりを捉えるのに十分です。
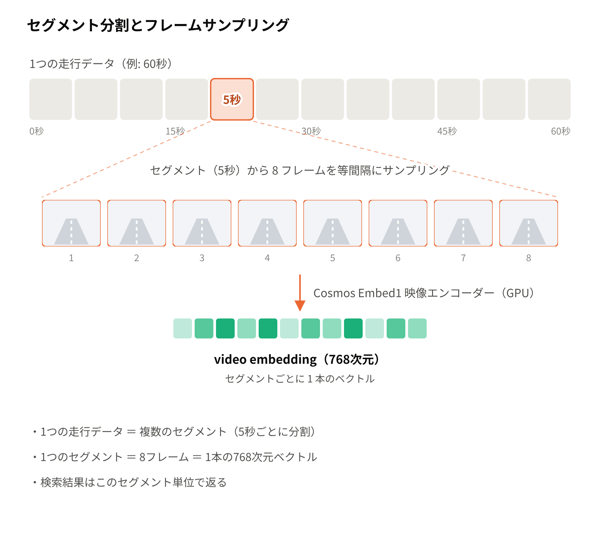
図6:セグメント分割とフレームサンプリングの模式図
また、embeddingモデルには世代交代があります。モデルを更新するときは、新しいモデルで全セグメントを再エンコードした新しいインデックスを用意し、検索側の参照を切り替える計画です。移行期間中に新旧のベクトルが混ざって検索されないよう、すべてのドキュメントにモデルバージョンを持たせ、検索時に必ずバージョンでフィルタする防御を最初から組み込んでいます。
全体をLambda、SQS、DynamoDB、OpenSearch Serverlessというマネージドサービスで構成し、GPUを使うバッチ処理のみAmazon EC2(AWS Batch)で動かしています。運用の手間を最小限に保ちながら、取り込み量の変動に柔軟に追従できる構成です。
GPU推論のエンジニアリング
インデックス側で最も計算資源を使うのが、video embeddingの生成です。9,000時間を超える初期バックフィルと日々の新規データを現実的なコストで処理するため、実測に基づいた最適化を重ねました。
インスタンス選定 — 速度はメモリ帯域幅で決まる
AWSのGPUインスタンス3タイプで推論時間を実測したところ、次の結果になりました。
|
インスタンス |
GPU |
演算性能(BF16) |
メモリ帯域幅 |
1セグメントあたりの推論時間 |
|
g6.xlarge |
NVIDIA L4 |
121 TFLOPS |
300 GBps |
1,190 ms |
|
g5.xlarge |
NVIDIA A10G |
70 TFLOPS |
600 GBps |
783 ms |
|
g6e.xlarge |
NVIDIA L40S |
362 TFLOPS |
864 GBps |
354 ms |
※演算性能は各GPUの公称値で、BF16 Tensor Coreのピーク値(スパース性なし)。
推論時間はGPUの演算性能(TFLOPS)では説明できず、メモリ帯域幅にほぼ反比例しました。象徴的なのはL4とA10Gで、演算性能はL4がA10Gの約1.7倍あるにもかかわらず、推論はA10Gのほうが1.5倍速くなっています。つまりこの推論は、GPUが計算よりもメモリとのデータのやり取りに時間の大半を費やす、memory-bandwidth-boundなワークロードです。帯域幅の大きいg6e.xlargeは時間単価こそ3タイプで最も高いものの、速度差がそれを上回り、1推論あたりのコストは最も低くなりました。
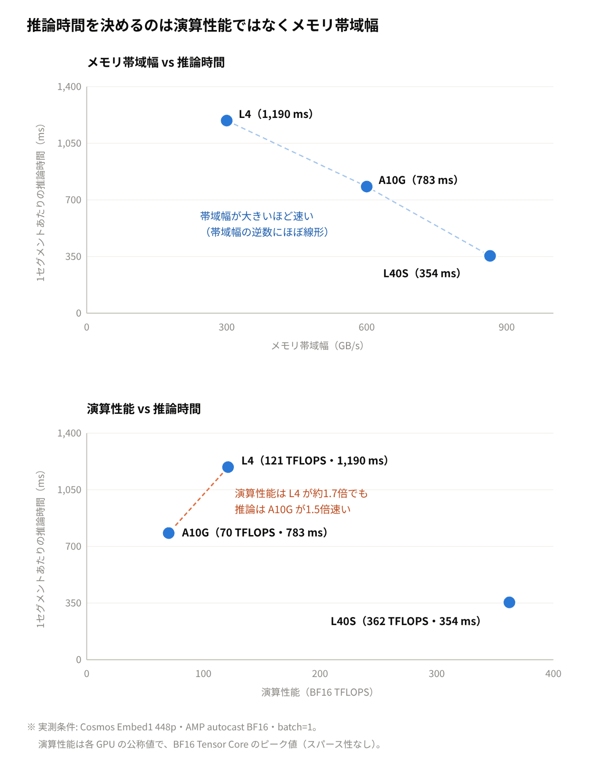
図7:メモリ帯域幅・演算性能と推論時間の関係
バッチ推論が効かない
GPU推論の定石であるバッチ化(複数の入力をまとめて推論し、スループットを稼ぐ手法)も検証しましたが、採用を見送りました。batch=2にすると、スループットはむしろ4〜9%悪化します。メモリ容量は48GBに対してピークは約8GBしか使っておらず、容量不足が原因ではありません。それでも速くならないのは、メモリ帯域幅がすでに飽和しているためです。入力ごとに読み書きする中間データがあるため、2つまとめて処理すると、メモリとやり取りするデータも2倍になります。その間、演算器の余力は使われないままです。そのため、今回のvideo embeddingの生成では、バッチ化してもスループットは伸びません。
torch.compileで推論時間を半減
一方で大きく効いたのがtorch.compileです。mode="reduce-overhead"の適用で、推論時間は354msから189msへ短縮されました(46.7%削減)。カーネル融合によってメモリトラフィック自体が減る、つまりボトルネックそのものが削られるため、このワークロードとの相性は抜群です。入力形状が完全に固定(1×8×3×448×448)されているため、再コンパイルも発生しません。コンパイルには起動時に約50秒かかりますが、これは次に述べるworkerの設計で償却します。
重いのは推論ではなく「推論を始めるまで」
GPU推論そのものは1セグメントあたり0.2秒弱です。しかし、GPU環境をゼロから立ち上げると、最初の推論までに合計6〜7分かかります。内訳を実測すると意外なことが分かりました。モデルの取得とロード(約1.8GBのアーティファクトをAmazon S3からダウンロード・展開しGPUへロード)は約30秒しかかかりません。支配的なのはGPUインスタンスの確保とコンテナーイメージの取得で、これが4分半〜6分を占めます。そこにtorch.compileの約50秒が続きます。
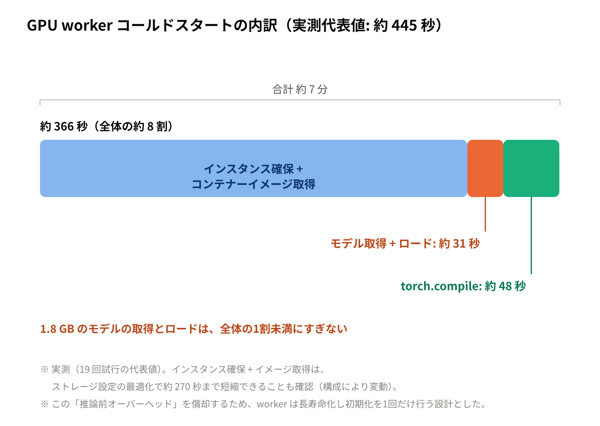
図8:コールドスタートの内訳 — 支配的なのはモデルロードではない
この実測は、2つの設計判断につながりました。
1つ目は、モデルをコンテナーイメージに焼き込まず、S3のアーティファクトとして起動時に取得する方式です。イメージが軽くなることで取得時間が短縮され、コールドスタート全体では約3割速くなりました。モデルの差し替えもS3上のファイルの入れ替えだけで済み、イメージの再ビルドと再配布は不要です。
2つ目は、処理対象を管理するscalerと、実際に推論するworkerの分離です。scalerは5分ごとに起動する軽量なLambdaで、キューに溜まった処理対象の量に応じて、必要な数のGPU workerをAWS Batch上に起動します。workerは長寿命のコンテナーとして動作します。起動時に一度だけモデルのロードとコンパイルを済ませ、あとはキューから処理対象を取り出してembeddingを生成し続け、キューが空になれば自動的に終了します。6〜7分の初期化は1回の起動で処理する多数の走行データに償却され、GPUの稼働時間は推論そのものに集中します。
この構成のスループットを見積もると、たとえば1分間の走行データは12セグメントに分かれ、1セグメント189msなら約2.3秒で処理できる計算です。worker1台の実効スループットは1時間あたり約1,500件で、日々の新規データはピーク時間帯でも1台で追従できます。9,000時間を超える初期バックフィル(数百万セグメント)も、並列数台の GPUで数日あれば完了する規模に収まりました。
つまり、効果があったのは2種類の施策です。推論そのものを速くする施策は、メモリ帯域幅を基準にしたインスタンス選定(1,190 ms → 354 ms)とtorch.compile(354 ms → 189 ms)です。推論を始めるまでを短くする施策は、モデルのS3アーティファクト化(コールドスタート約3割短縮)とworkerの長寿命化(処理データ量あたりの初期化オーバーヘッドの削減)です。一方、GPU推論の定石であるバッチ化は、今回のワークロードでは効果がなかったため、採用していません。
まとめ
MOBの走行データ検索に、NVIDIA Cosmos Embed1を用いた自然言語シーン検索を追加しました。キャプションという中間表現を介さず映像を直接ベクトル化するアプローチにより、登録されるすべての走行データを、最小の追加コストで、自由な言葉で検索できるようになりました。それを支えているのは、既存検索と共存させる二段構えのインデックス構成、DynamoDBをSOTとした復元可能なデータ設計、そして実測に基づくGPU推論の最適化です。推論そのものは、メモリ帯域幅を基準にしたインスタンス選定とtorch.compileにより1セグメント189 msまで短縮しました。推論を始めるまでのオーバーヘッドは、モデルのS3アーティファクト化とworkerの長寿命化により、処理データ量あたりで小さくしています。結果として、9,000時間を超える初期バックフィルを数日・現実的なコストで処理できる水準に到達し、日々の新規データはピーク時間帯でもworker1台で追従できています。
embeddingモデルは、これからも世代交代を続けていきます。本機能はモデルバージョンを前提とした切替設計を最初から備えており、モデルの進化をそのまま検索品質の進化として取り込めます。検索対象データの拡大やメタデータとの連携も含め、自動運転の開発を支えるデータ基盤として、MOBはこれからも進化を続けます。
日野 裕介 | ML & データインフラストラクチャー部
2021年、ティアフォーに入社。以来、自動運転車両が記録する走行データをクラウドで収集・管理するデータ基盤の開発に従事。現在は、自動運転システムを可観測にする内製基盤MOB(Mobility Observer)の開発・運用を担当し、本記事で紹介した自然言語検索機能の設計・開発を推進している。
ティアフォーでは、「自動運転の民主化」というビジョンに共感を持ち、自らそれを実現する意欲に満ち溢れた新しい仲間を募集しています。
今回のチームで募集中の職種
その他にも多くの職種で採用をしています。詳細は、ティアフォーの「求人ページ」をご覧ください。
「どの職種で自分の経験を活かせるかが分からない」「希望する職種が見つからない」などの場合は、ぜひ「キャリア登録」をお願いします。
お問い合わせ先
-
メディア取材やイベント登壇のご依頼: pr@tier4.jp
-
ビジネスや協業のご相談: sales@tier4.jp
ソーシャルメディア
X (Japan/Global) | LinkedIn | Facebook | Instagram | YouTube
関連リンク